
En un mundo dominado por el crecimiento exponencial de datos, gestionar grandes repositorios atípicos como los data lakes se ha convertido en un desafío complejo y costoso. DuckLake 1.1, la última versión del formato open-source desarrollado por DuckLabs en Ámsterdam, promete transformar esta realidad al introducir un método radicalmente más sencillo y eficiente para organizar y manejar esos datos.
La propuesta de DuckLake es directa: en lugar de dispersar los archivos de manifiesto por todo el almacenamiento de objetos, utiliza una base de datos SQL estándar para almacenar los metadatos de las tablas. Esto convierte la gestión del lakehouse en un problema de base de datos relacional, facilitando la consulta y el seguimiento de las versiones de cada tabla. En esencia, simplifica la arquitectura tradicional del data lakehouse y mejora notablemente su rendimiento.
Este formato trabaja con archivos Parquet para almacenar los datos, una solución que comparte ciertas características con el propio sistema DuckDB sobre el que se ejecuta, ambos organizados en grupos de filas y diseñados para manejar datos en formato columnar. Esta afinidad reduce significativamente la necesidad de procesos intermedios para procesar la información, haciendo el sistema más rápido y ligero. 
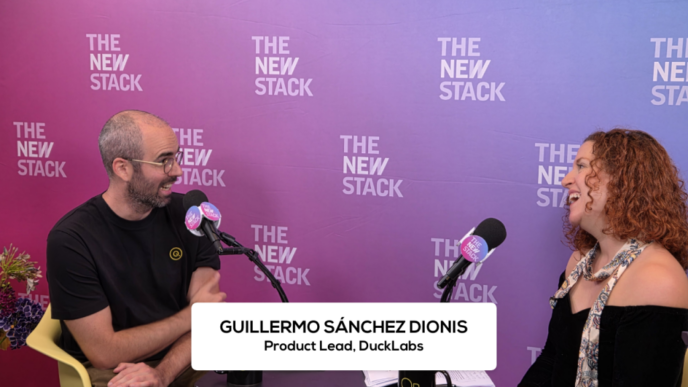
Pedro Holanda, ingeniero principal y líder de desarrollo de DuckLake, explica que esta simplicidad permite que los usuarios sepan siempre qué archivos Parquet deben consultarse para responder una consulta SQL. «El servidor responde directamente cuáles son los archivos pertinentes, y solo cambia el catálogo de metadatos, nunca los archivos Parquet en sí», afirma Holanda.
Otro de los problemas habituales que resuelve DuckLake es el de los «pequeños archivos», recurrente en entornos de streaming de datos múltiples. Mediante técnicas como la combinación (gluing) y el flush, el sistema consolida numerosos archivos pequeños en uno solo, optimizando así el número de solicitudes y mejorando la eficiencia en la lectura y mantenimiento del data lake.
En el panorama competitivo actual, donde la interoperabilidad y portabilidad de datos son esenciales, DuckLake facilita que diferentes sistemas y motores analíticos puedan intercambiar información sin la necesidad de complejas migraciones o transformaciones de datos. Esta capacidad, unida a su naturaleza open source bajo licencia MIT, ha captado recientemente la atención de gigantes tecnológicos como Amazon.
Durante la presentación de resultados del tercer trimestre, Andy Jassy, CEO de Amazon, destacó la dificultad que enfrentan los clientes para mover datos entre diferentes almacenes y motores analíticos. A raíz de la adquisición de DuckLabs por parte de AWS, Jassy señaló que DuckDB y DuckLake ayudarán a convertir el dialecto SQL de AWS en un estándar universal, permitiendo ejecutar las mismas consultas SQL en cualquier servicio analítico de AWS sin coste adicional por migración.
Esta integración promete facilitar un análisis de datos fluido, eficiente y con menos fricciones, un factor clave en la evolución de la inteligencia artificial y el procesamiento avanzado de datos.
Desde su lanzamiento simultáneo con DuckDB 2.0.0 LTS en octubre, DuckLake 1.1 incluye mejoras significativas que van más allá de la reducción del número de archivos. La versión actual incorpora más de 200 correcciones de errores que refuerzan su estabilidad y calidad, además de optimizaciones para operar de forma nativa en DuckDB.
En definitiva, DuckLake 1.1 representa un avance importante en la simplificación del manejo de grandes volúmenes de datos, facilitando la vida a los desarrolladores y agilizando la explotación del dato en entornos de inteligencia artificial y análisis avanzado.